 老師怎麼辦
練習的時候,回饋要給到什麼程度
給太多,老師會照著念;給太少,練習就變成瞎猜。這篇講我們怎麼決定這條線畫在哪:四種回饋各自的出現時機、建議從第幾階開始給,以及這套設計在師培課上可以怎麼用。
·9 分鐘
老師在模擬器裡打完一句話送出去,系統該回他什麼?
這題我們來回改了很多次。給太多,他會照著畫面上的句子念,練完就忘;給太少,他卡在那邊,練習就變成瞎猜。
這篇講我們怎麼決定這條線畫在哪、為什麼這樣畫,還有你實際用起來會看到什麼。
先講我們想要什麼
三件事。順序就是優先序。
一、離開這個系統之後還做得到。 練習當下表現好不算數,我們要的是他下次站在真的孩子面前的時候。
二、不要在練習裡練成壞習慣。 有些話講出去是會出事的,這種不能等他自己發現。
三、順便練「講得出自己卡在哪」。 這其實是現場很吃的一個能力,而且可以練。
第一點我們特別在意,是因為看到一個有點嚇人的研究。2025 年發表在 PNAS 的一項隨機對照試驗,把土耳其一所高中約一千名學生分三組上四堂數學課:一組用會直接給答案的 AI,一組用只給提示的 AI,一組沒有 AI。
練習當下,直接給答案那組進步 48%,只給提示那組進步 127%。但把 AI 撤掉之後再考一次,直接給答案那組比從來沒用過 AI 的那組還差;只給提示那組則沒有顯著差異。
也就是說,工具做得太貼心,是會讓人以為自己學會了的。我們不敢保證自己躲得過這個坑,但至少可以把「撤掉之後還做不做得到」當成要看的指標,而不是只看練習當下順不順。
回饋有四種,出現的時機不一樣
畫面上會出現的東西分成四層。分層不是為了整齊,是因為它們的開關條件不一樣。
第 0 層
法規紅線
同一回合就跳第 1 層
安全底線
結束後一起看第 2 層
這一局的目標
全程在畫面上第 3 層
融合教育理念
只在覆盤
第 0 層,法規紅線
「再不回去我就記你一支警告」「叫你媽來把你帶回家,明天也不用來」——這類話送出去之後,同一個回合就會跳出提醒,告訴你這句話在法律上的位置。
這一層背後是 18 條規則。每一條都掛著實際的法條依據——教基法、教師法、兒少法、特教法、輔導管教注意事項、校園霸凌防制準則——以及可以點進去查的全國法規資料庫連結。我們沒有自己寫「這樣好像不太好」,是把條號放在那裡讓你自己看。
偵測分兩段:明顯的先用關鍵字掃(「拖出去」「站到放學」「退學」),剩下的交給模型判讀語意。因為同一件事有一百種講法,而「你再這樣,我等一下就打電話請你媽現在過來把你帶走」裡面一個關鍵字都沒有。
這一層永遠開著,連最後那個標示「沒有任何協助」的關卡也開。理由是它不算提示,是護欄——提示是幫你學快一點的東西,可以拿掉;護欄是防止你練成錯的東西,拿掉就沒意義了。
順帶一提,這是我們自己做邊界測試才發現的洞:有兩條規則當初只掛在課堂情境上,結果在「下課後單獨談話」那一局,老師講「你再這樣我就打你手心」,一條都不會跳。身體完整性跟受教權不是情境專屬的,後來補上了。
第 1 層,安全底線
不違法,但會傷到關係的那些做法。目前歸納成 8 種型態:沒先確認狀態就下常規要求、拿「叫家長來」當即時籌碼、把同學變成觀眾或執行者、「去旁邊站一下」但人離開了你的視線⋯⋯
每一種型態後面都綁著一張去識別化的真實案例卡:發生了什麼、哪一步跨過去了、後來怎麼收場,還有一句「如果重來可以怎麼做」。這些案例都有出處——監察院的糾正案、人本教育札記、媒體報導。其中最嚴重的一件,是「分開冷靜」被執行成無人看顧的獨處,最後出了事。
這一層不當場跳,留到結束後一起看。兩個理由:它講的是整局的模式,不是單獨哪一句話;而且案例這種東西要進到反思狀態才讀得進去,當下跳出來只會把演練玩成「避開會觸發警告的字」。
第 2 層,你這一局的目標
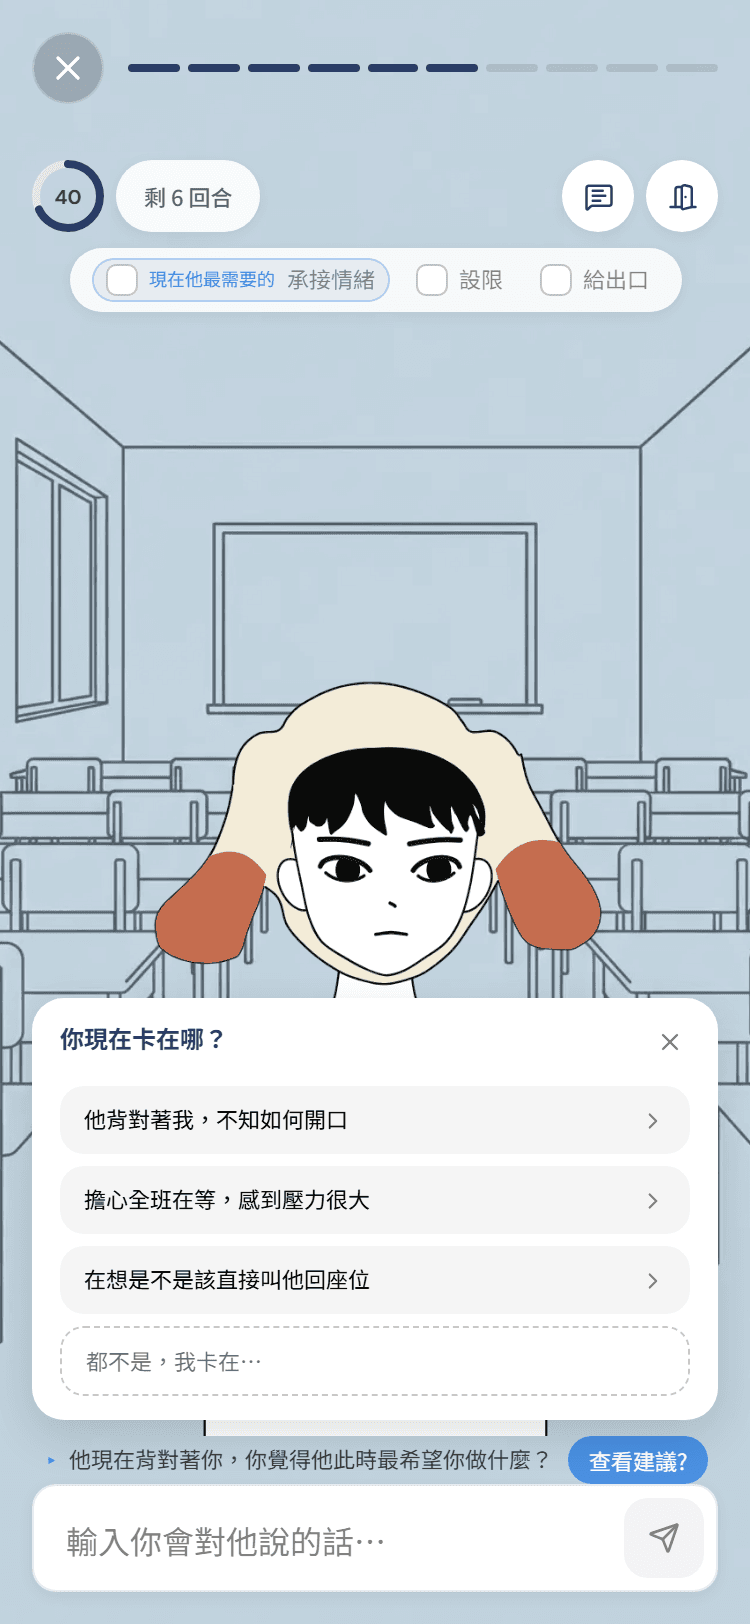
畫面上方那排步驟,來自你開始前挑的那套策略。其中一項會被標成「現在他最需要的」。
這個標記刻意不叫「下一步」。那幾個步驟不是 1→2→3 的流程,而是部分順序——有的步驟要求先做過前一步,有的不用。標成「下一步」會把約束講得比實際強,而且會訓練出最糟的那種練習方式:照著卡片走完,不看孩子。
所以焦點是由孩子當下的狀態決定的。它可以往回指你已經試過、但他沒接住的那一步,也可以直接跳過中間。
第 3 層,融合教育理念
你剛剛做的那件事,跟融合教育的原則有什麼關係——以及它為什麼會有用、又會在什麼情況下失手。
每張策略卡上除了步驟,還寫著它的原理(像是「他激發越高,越聽不懂道理——不是不受教,是這時候大腦真的處理不了語言」)、它的優點與缺點、它會怎麼壞掉,以及它出自哪一套研究。卡片底下直接印著參考來源:低激發取向、情緒教練、功能本位思考、Kounin 的「兼顧全班」。
這一層在你挑策略的時候看得到,然後就退場,留到覆盤再回來。不在演練當下講,是因為那個時候你需要的是看孩子,不是看理論。
那這四層在畫面上怎麼擺
不是四個區塊。上面那張圖講的是「什麼時候」,下面這張講的是「送出一句話之後,同時有哪幾件事在跑」——這是另一個切法,兩張要疊起來看。
老師送出一句話
學生的反應
約 1.5 秒
一句台詞、一個表情、一個動作。他會回應你剛剛說的那一句,不是回應「正確答案」。
不會做的事:不會直接說出自己為什麼會這樣。
即時的紅線提醒
幾乎不用等
只有在那句話踩到法規紅線時才會出現,例如威脅體罰、剝奪上課權利。
不會做的事:沒踩到就完全不出現,不會碎念。
教練讀這一回合
約 2 秒
更新畫面上的目標清單,把他現在最需要的那一步框起來、標亮(點下去才說為什麼),再換一個要你看孩子的問句。
不會做的事:不評價你做得好不好。
- 1你現在卡在哪?(三個貼著這一局的選項,或自己打)
- 2往哪個方向走、要看孩子的什麼訊號
- 3真的要的話,才給一句可以照著說的話
每往下一階都要你再按一次。想直接拿台詞可以,但你會先被問一次「你卡在哪」。
分開的理由是不要互相打斷。孩子要快,因為那是對話本身;教練可以晚一點,因為它是旁邊的資訊;而真的會給你台詞的那個東西,要你自己按才會出現。
開始之前,先挑一套你想練的
進場前系統會請你選一套策略。
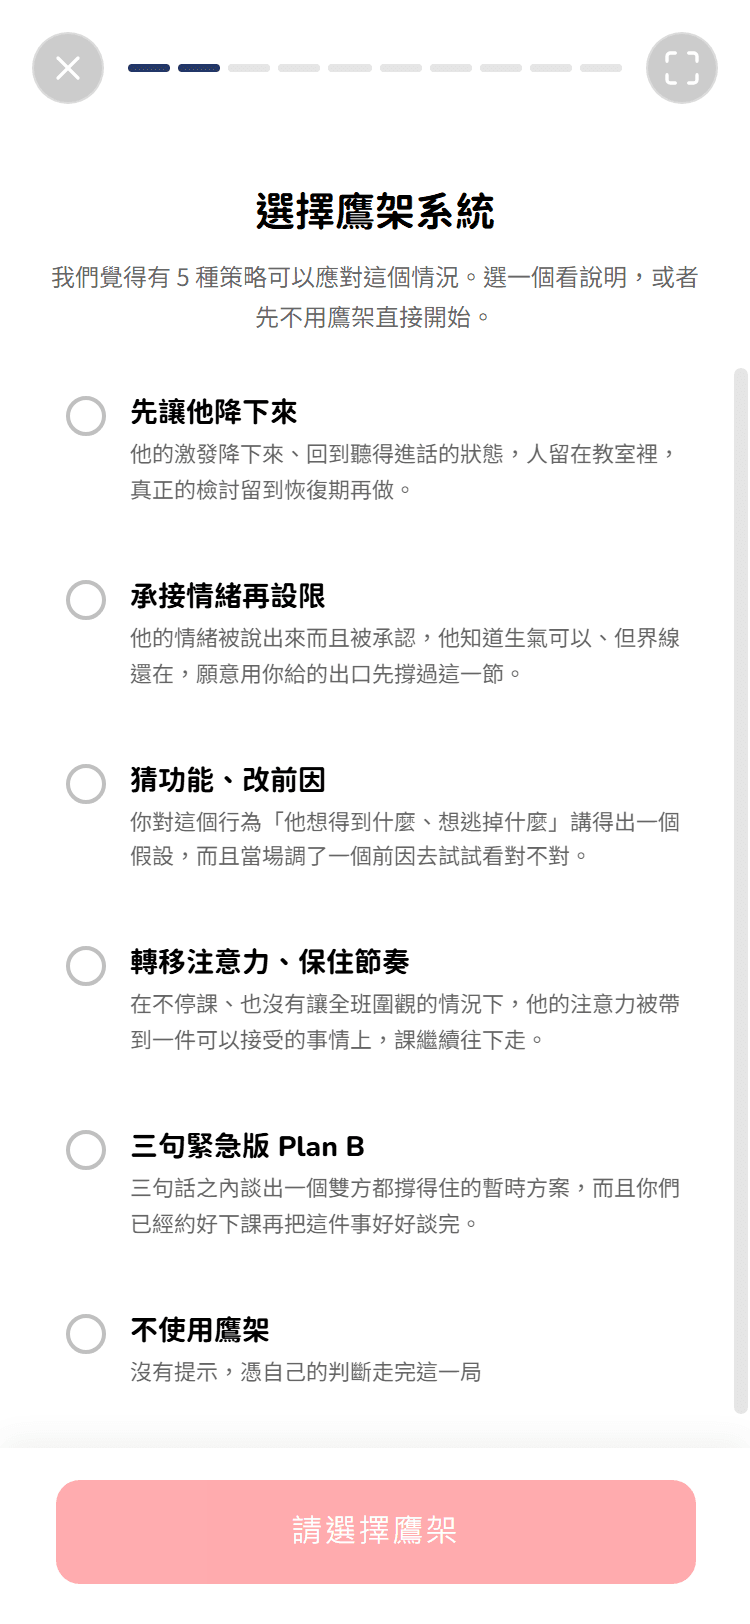
這不是難度選項,是你這一局想練什麼。選了「承接情緒再設限」,上方的清單就會換成那三步,你打的每一句,教練都照那三步來讀。
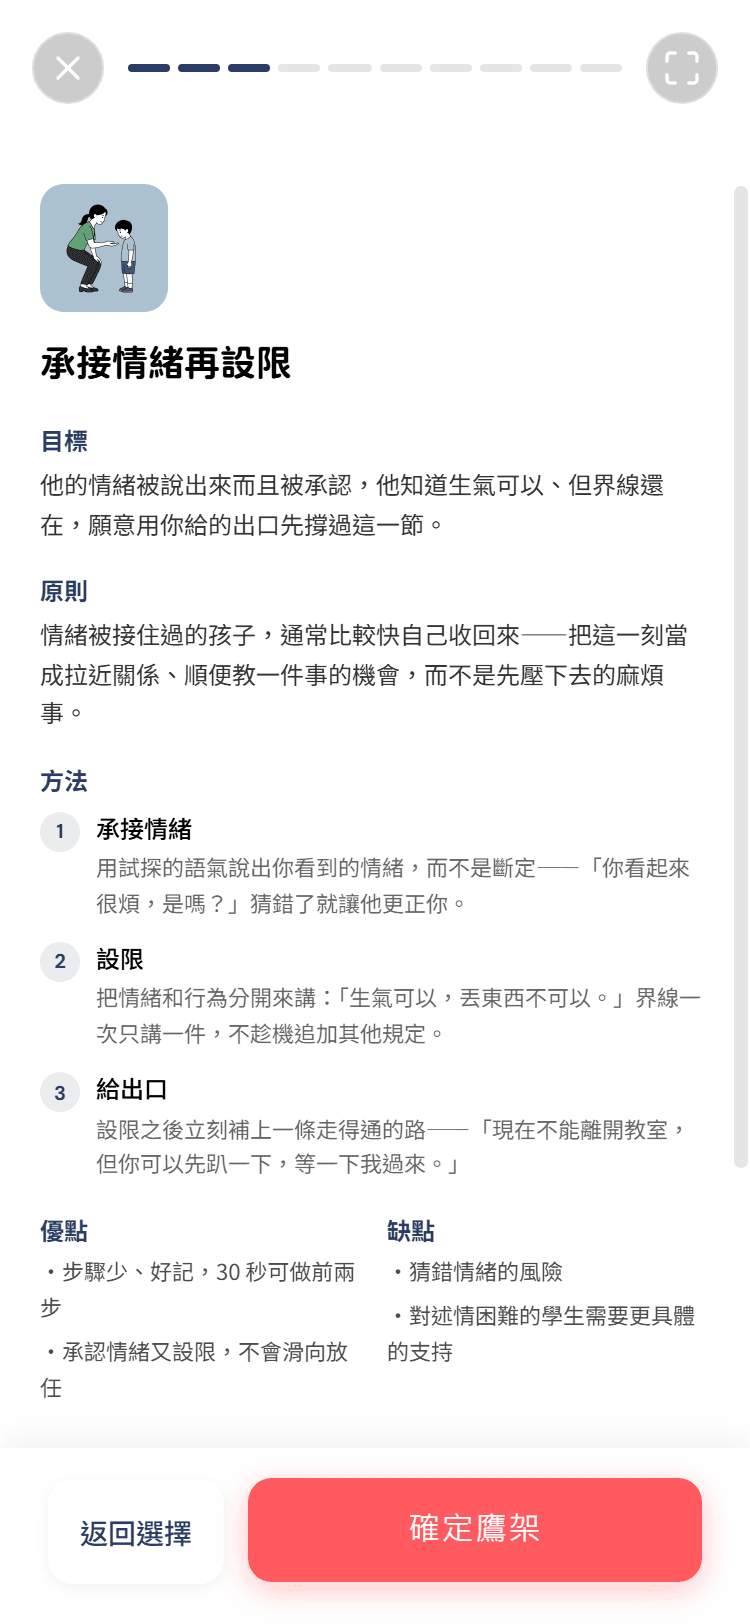
每一套後面都掛著缺點。
這個我們考慮蠻久的。把缺點寫出來,等於承認給你的東西不是萬用解,看起來有點自砸招牌。但只講優點的策略就不是策略了,是口號,而口號拿去用在真的孩子身上會出事。
至於「要不要讓提示隨著練習次數慢慢變少」,查完資料之後我們決定不做。一份涵蓋 144 個實驗的後設分析發現,電腦鷹架整體有中等效果(g = 0.46),但有沒有淡出並沒有造成差別。既然如此,最後那個不給鷹架的關卡,我們就不把它包裝成「拿掉輔助讓你學更深」,直接當測驗用:看你離開提示之後還做不做得到。
按下「查看建議」之後
這是整個設計最容易被嫌棄的地方——你按了,不會馬上拿到一句可以念的話。
會先問你:你現在卡在哪?
後面是一個四階的階梯:
- 你現在卡在哪?(常駐的問句,會隨孩子的狀態換)
- 三個選項,或自己打。選項是照著你這一局真的發生過的事寫的
- 一個方向,加上「要看孩子的什麼訊號來決定」——但不給台詞
- 再按一次,才給一句可以照著說的話
順序是刻意倒過來的。
教育研究把回饋分成四個層次:自我層(「你好棒」)、任務層(這句對不對)、歷程層(你用了什麼策略)、自我調節層(下次你怎麼自己檢查)。直覺上會覺得任務層最實用,但證據剛好相反——越往後面的層次,留得越久。
一份回顧 435 個研究、將近 1,000 個效果量的後設分析發現,回饋整體有中等效果(d = 0.48),但差異極大,而真正決定效果的是資訊含量:同時涵蓋任務、歷程、自我調節三層的回饋最強,只告訴你「對或錯」的最弱。
所以這個階梯把最強的擺在預設位置,最弱的擺在要按兩次才拿得到的地方。
還有一個理由來自求助行為的研究:學習者通常不是不求助,就是濫用求助(直接要答案)。有效的求助有兩個條件——先自己試過,而且拿到的是原則不是答案。所以第 2 階那個「你卡在哪」不是通往建議的過場,它本身就是內容:把自己卡住的地方講出來,這個動作就是在練自我調節。
你要一路按到底直接拿台詞也可以,我們不擋,也不扣你任何東西。只是你會先被問一次。
我們刻意不說的話
四個層次裡的自我層,也就是「你做得很好」「你很有同理心」這種,在這個模組裡完全不存在。
教練的每一句話都禁止出現稱讚或責備的形容詞。它不會說「你承接得很好」,它會說「你說了『你看起來很煩』之後,他回了一句完整的話」。
形容詞換成引述。因為「很好」只告訴你結果,引述則是同時告訴你發生了什麼、還有你做了什麼讓它發生。
另外,按「查看建議」不扣任何東西——不扣回合、不扣分數、結尾也不會說你用了幾次提示。會在卡住的時候停下來說「我卡在他不理我」,這件事本身就是我們想練的。
你可以怎麼用它
如果你是自己來練的老師:先自己打,真的卡住再按建議,然後停在第 2 階想一下再往下。想直接看台詞當然可以,但那樣它就只是一本台詞本了。結束後的覆盤比演練本身更值得花時間——它講的是你整局的模式。
如果你在帶師培課或工作坊:這幾個地方可以直接當教案素材用。選鷹架那一頁本身就是一個很好的討論起點(為什麼這一題你選這套?),五套策略的「缺點」欄可以拿來吵;四層的分法可以當共同語言,讓大家討論「這句話是踩線,還是只是不夠好」;最後那個沒有協助的關卡可以當成前後測。
如果你在做研究:我們怎麼驗收「模擬出來的孩子像不像」、那組檢查項目長什麼樣,寫在另一篇。歡迎拿去用,也歡迎告訴我們哪裡想錯了。
參考文獻
- Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. PNAS, 122(26). doi:10.1073/pnas.2422633122
- Hattie, J., & Timperley, H. (2007). The power of feedback. Review of Educational Research, 77(1), 81–112. doi:10.3102/003465430298487
- Wisniewski, B., Zierer, K., & Hattie, J. (2020). The power of feedback revisited: A meta-analysis of educational feedback research. Frontiers in Psychology, 10, 3087. doi:10.3389/fpsyg.2019.03087
- Aleven, V., Stahl, E., Schworm, S., Fischer, F., & Wallace, R. (2003). Help seeking and help design in interactive learning environments. Review of Educational Research, 73(2), 277–320. doi:10.3102/00346543073003277
- Belland, B. R., Walker, A. E., Kim, N. J., & Lefler, M. (2017). Synthesizing results from empirical research on computer-based scaffolding in STEM education: A meta-analysis. Review of Educational Research, 87(2), 309–344. doi:10.3102/0034654316670999
- Chernikova, O., Heitzmann, N., Stadler, M., Holzberger, D., Seidel, T., & Fischer, F. (2020). Simulation-based learning in higher education: A meta-analysis. Review of Educational Research, 90(4), 499–541. doi:10.3102/0034654320933544
最後一篇是模擬本身的效果證據:涵蓋醫學、師培與管理領域 145 個研究的後設分析,整體效果量 g = 0.85。同一份研究也發現,先備知識低的人從看範例得到比較多,先備知識高的人從反思階段得到比較多——這是我們把「看示範」放在演練前面、把「覆盤」放在後面的原因。